
1、引言
在高频业务:一种IP网段判断重叠的算法(其三)中,我们拓展了IP重叠算法的应用面,并设计了新的数据结构,来解决业务碰撞的问题。同时使用扫描线算法解决新的包含业务属性的数轴的构建。
本篇博客中,笔者讨论如何将设计好的数轴工程化,给业务带来收益。
2、数轴的抽象
已知我们构造了一条无限长的数轴,它上面有不计其数的线段,包括一个又一个IP段,以大段包含小段的形式存在。
当我们仔细看其中的某一段时,我们能够看见他的(start, end, length, attributes)这四类属性。
同时,针对attributes也是业务属性。它的性质是,子段必然继承父段的业务属性,这很好理解,一个人的身份可以是老师,但是他属于更大的范围,也就是中国人。
那么利用这个业务性质,当我们通过扫描线算法构建好数轴后,我们可以轻而易举的使用一个单IP,用二分法遍历数组,取出其所有属性。
那么这就够了吗?
3、遍历加速 – IP前缀树
当我们用二分法遍历数组时,我们本质上是在依赖IP的起始和结束点,但由于我们的数轴上是线段 而不是一个一个点,因此这种算法不是最优的。
那么最优的方法是什么呢?答案是IP前缀树。
IP前缀树是一颗二叉树,以01编码,它将IP地址转化为二进制后,然后在树上按照01的顺序进行走一轮。就确定了这个IP的位置。
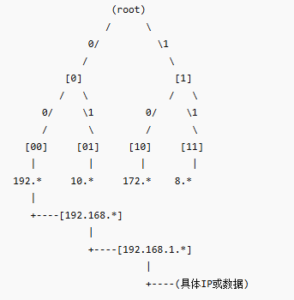
一颗IP前缀树可以理解为,每个IP的遍历方式都是从root节点开始,依次往下。直到找到具体的IP。
而IP前缀树的数据输入,就是一系列IP段。
以golang语言为例:
有以下输入:
[
[“192.168.0.0/16”, “电商”, “华东”],
[“192.168.1.0/24”, “支付”, “核心业务”],
[“10.0.0.0/8”, “内网”, “办公”]
]
整体流程可以分为以下几个步骤:
1.解析CIDR,获取子网掩码(重要)
2.IP转二进制(01010…),二进制本身就意味着一条路径
3.根据获取到的子网掩码,判定使用前N位,作为IP前缀树的插入路径
4.0就走左节点,1就走右节点
5.直到这条二进制走完
ip前缀树的每个节点格式如下:
type TrieNode struct {
Zero *TrieNode
One *TrieNode
Tags []string
IsPrefix bool
}
一个节点需要包含它的左右子节点,是否有效前缀,以及当前节点的附加值(在我们这个样例中,就是业务属性)
更详细的说:
_, ipnet, _ := net.ParseCIDR(“192.168.1.0/24”) //拿到子网掩码
192.168.1.0
=
11000000 10101000 00000001 00000000 //拿到二进制路径
root
└──1
└──1
└──0
… //走二进制路径
在这个插入过程中:
1.从根节点开始
2.遍历 CIDR 对应的前缀位
3.每一位决定向左或向右
4.不存在节点则创建
5.遍历结束后,将业务标签挂载到当前节点
这样天然形成最长前缀匹配结构。
相应的,在查询IP时
例如:
192.168.1.55
1.转换为二进制
2.从根节点逐位向下匹配
3.在遍历过程中记录最近一次命中的有效前缀节点
4.遍历结束后返回最长匹配结果
该方案的优势:
1.天然适配ip段的匹配场景 – 最长前缀匹配,实际业务中,一个业务组往往来自于一个机房的固定网段。一个公司也常常为不同团队划分不同的内网网段。
2.查找快,按位匹配
3.插入/删除简单,动态更新容易,无需匹配其他条目
4.能够应用连续内存优化,对支持内存分配的编程语言来说,可以获取更高的搜索性能提升。
此外,如果你使用clickhouse,那么clickhouse的ip_trie类型的dict,是天然支持ip前缀树的,恭喜你,可以直接拿来用!
4. 工程化的前提 – 内存压缩
考虑以下问题,我们有300万IP记录,每个IP记录包含10个属性,那么这会占用多少内存呢?即使IP前缀树本身已将存储压缩至极致,但业务属性并不会压缩。
以下是简单估算:300万 × 240字节 ≈ 720MB
哈希表(如使用Map):额外30-50%开销,约1-1.5GB
这显然是有些难以接受的。它随着IP数量和业务维度数量急剧扩张,难以处理千万乃至上亿的记录。
因此我们需要使用一些手段。以下是笔者的工程化,当然不局限于此。好的工程化是根据业务需求有所变更的,你也可以选择你的方式。
4.1. 统一Entry池:
我们知道在实际业务中,随着IP数量的增长,业务标签的数量反而会下降趋于一个稳定值。这在常见的IP地理信息库应用中非常普遍。可能10%的国家都是美国。那么这10%显然是重叠存储。对吧?
所以我们可以用一个统一的业务属性池来维护内存。一个ip索引持有这个属性池的指针就好了。这样我们的业务维度不再是O(M*N),而是O(N)
4.2. 连续读写内存
IP前缀树本身是一颗01树,当我们在这棵树上进行查询时,我们就要访问内存。如果是一颗指针构成的二叉树,那么内存读写和你的查询次数是一致的或者会超过它。
但是当我们将二叉树的所有节点都放入一块连续内存,问题就变得有所不同了,每次可以读取出大量节点,增加查询速度。
4.3. 并发
ipv4/ipv6可以分开并发,单个数组内的所有查询也可以分开并发,交给cpu去做。因为本质上只是在树上行走而已,这颗树上有多少人同时在走,并不重要。
以上就是《高频业务:一种IP网段判断重叠的算法》的全部内容了,笔者从一次简单的IP重叠算法优化起,将其逐渐拓展为了一种普遍的,高性能的适用于IP业务碰撞的算法。在这个过程中的解题与思考,供大家参考。